
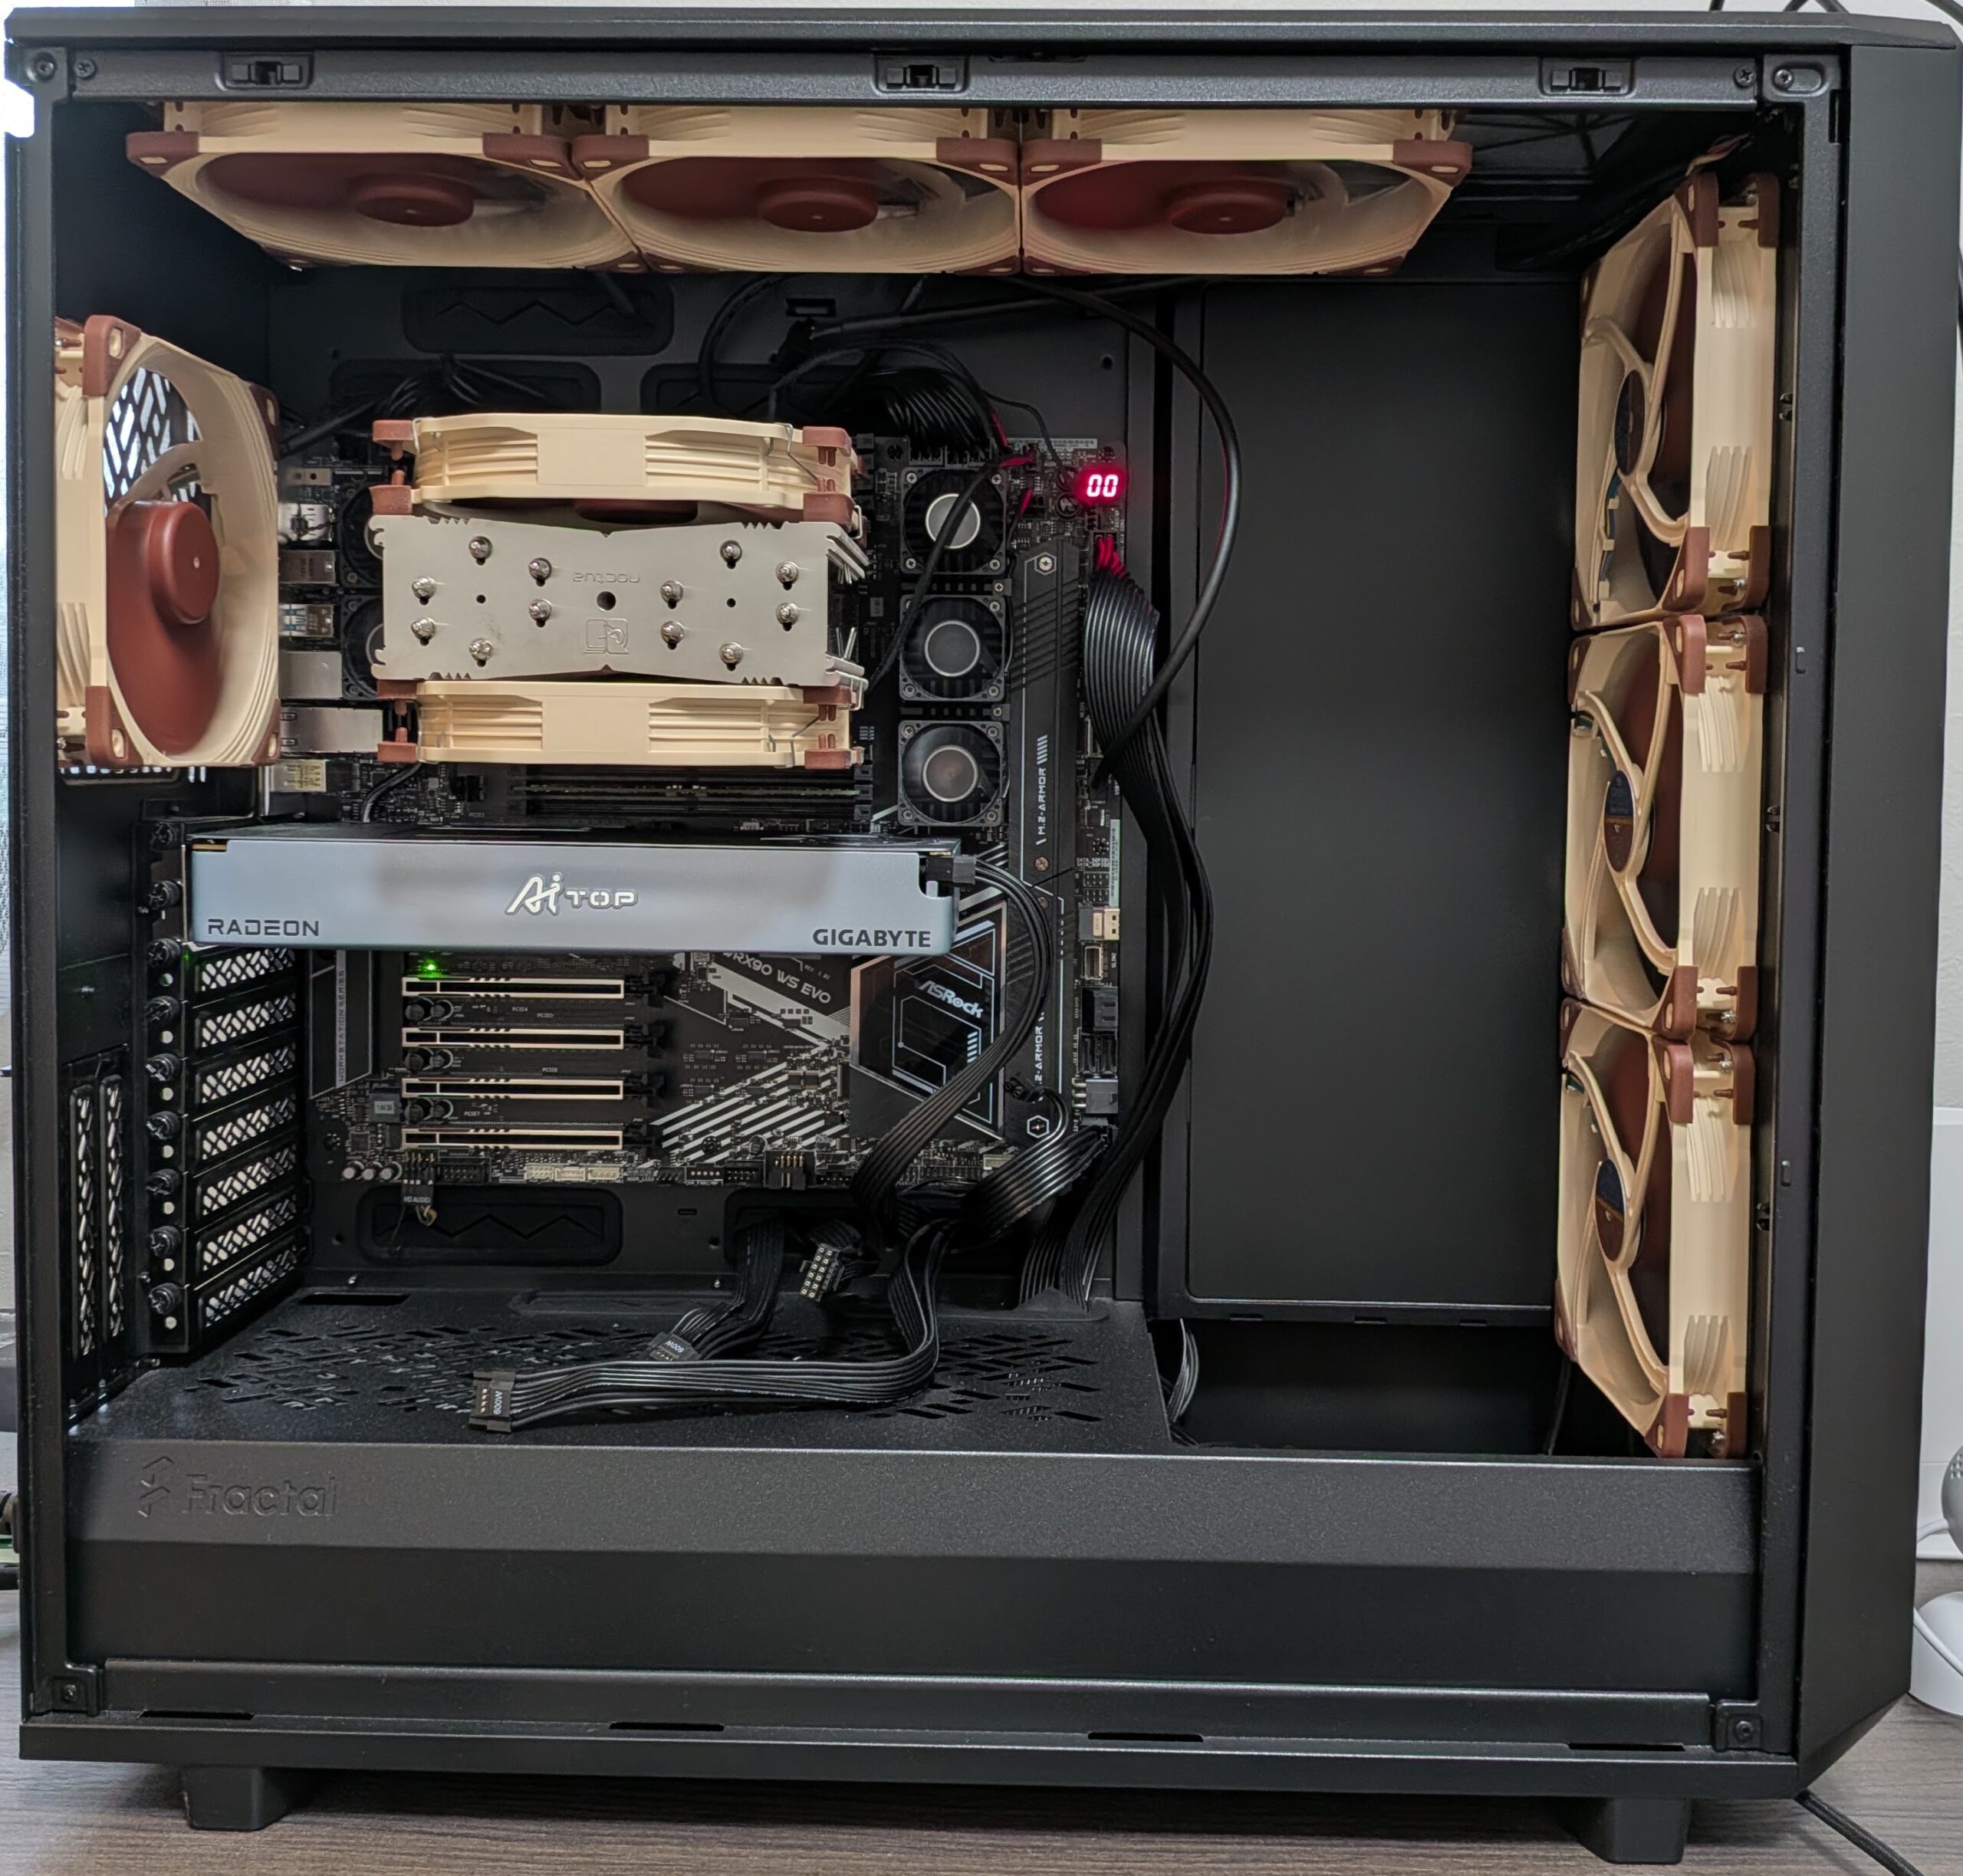
はじめに:自宅サーバー「Gen2」始動
当ブログの自作サーバーとして以下「Gen1」を運用してきました。しかし今回、サーバーの環境を新たに「Gen2」として大幅に刷新しました。
▼Gen 1(Windows)の構成はこちら。
今回の構成ではハードウェアを一新するとともに、メインの開発環境をこれまでのWindowsからLinuxネイティブへと移行しました(クリエイティブ用途への保険として、物理SSDを分けたデュアルブートでWindows環境も維持しています)。
ここでは、Gen2の現在のハードウェア構成と、なぜこの環境構築に至ったのか、その背景や設計思想をお話しします。
なぜハードウェアを変えたのか? Threadripper PROを選んだ理由
Gen 1はRyzen 9 9950X3DにマザーボードはサーバーグレードのASRock Rack B650D4U-2L2T/BCMという構成でした。十分に強力ですが、今回さらにThreadripper PRO 9965WX、マザーボードは同じくサーバーグレードのASRock WRX90 WS EVOに変更しています。
理由は、ローカルAIを動かしてみたかったからです。ローカルで強力なモデルを、できるだけ速度を落とさずに動かそうとした時、Threadripper PROには優位性があります。
PCIeレーン数、メモリ帯域の差
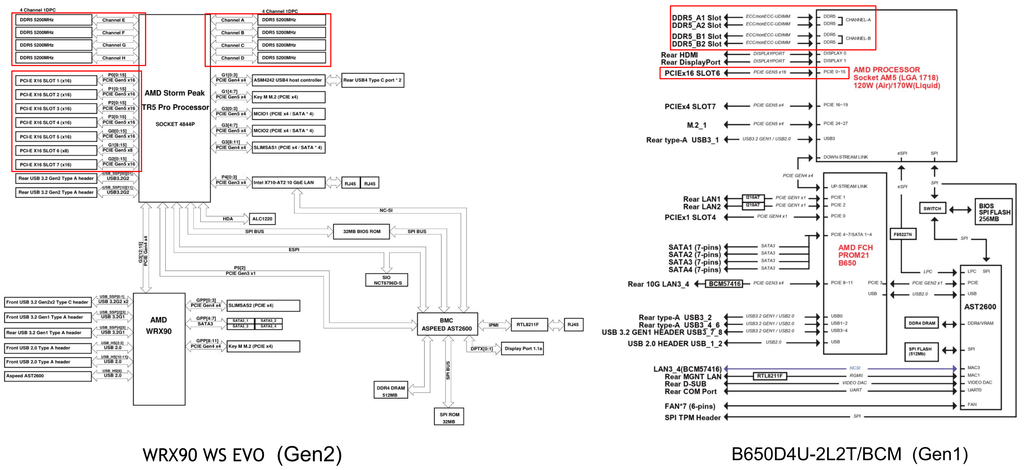
B650D4U-2L2T/BCM:https://www.asrockrack.com/general/productdetail.jp.asp?Model=B650D4U-2L2T/BCM#Manual
上の図にマザーボードの比較を載せました。これらはユーザーマニュアルの図を引用したものです。
Gen2ではGPUを接続するPCIe x16スロットが6基あります(Gen1は1基)。空冷タイプの2スロット厚GPUを載せる場合でも、Gen2なら実質4枚を搭載可能です。
次にメモリスロットを見ると、Gen1の4本(2チャネル)に対して、Gen2は倍となる8本(8チャネル)を備えています。 では、この「スロット数(搭載できる物理的な数)」と「PCIeレーン数やメモリチャネル数(通信帯域)」の差が、実際のパフォーマンスや運用にどのような違いをもたらすのでしょうか。
ここでは、ハードウェアの設計限界を示す「プラットフォームとしての最大ポテンシャル(理論値)」と「現在の実運用(スモールスタート)」という2つの視点から、その差を紐解いていきます。
プラットフォームとしての「最大ポテンシャル」比較
メモリ帯域と拡張性:仕様書が物語る「3600MHz vs 7600MHz+」と「2TB」の壁
メモリ容量は搭載するモジュールによって選べますが、CPUとメモリを結ぶ「データ転送経路(チャネル数・帯域)」はマザーボードの物理配線によって決定されます。
1. Gen1(B650D4U-2L2T/BCM):最大2チャネル
スロットは4本ありますが、配線は2チャネルです。最大容量は1スロットあたり48GB、合計で最大192GBとなります。
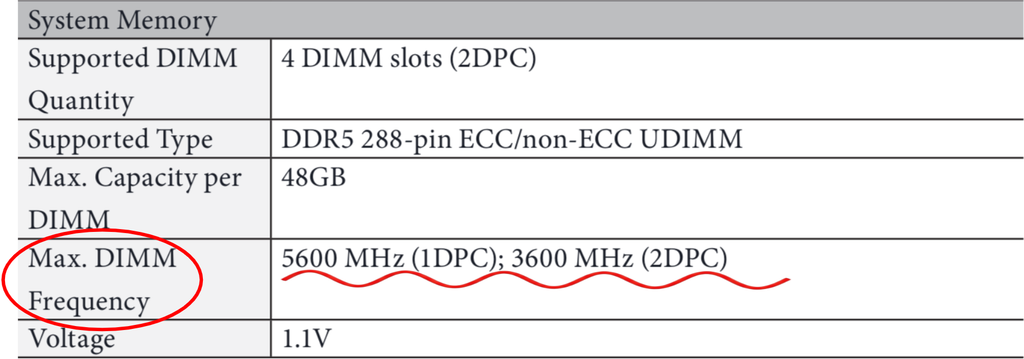
最大の注意点は動作周波数の制約です。 仕様書にある通り、1チャネル1枚(1DPC)であれば5600 MHzで動作しますが、4スロットすべてを埋める(2DPC)と、信号品質の都合上「3600 MHz」まで強制的にクロックが落とされます。帯域にして実質約57 GB/s程度にまで目減りしてしまいます。
2.Gen2(WRX90 WS EVO):完全独立 8チャネル(1DPC・最大2TB)
8本のスロットすべてが独立したメモリチャネル(1DPC)としてCPUに直結しています。スロットをすべて埋めても速度低下が起きません。
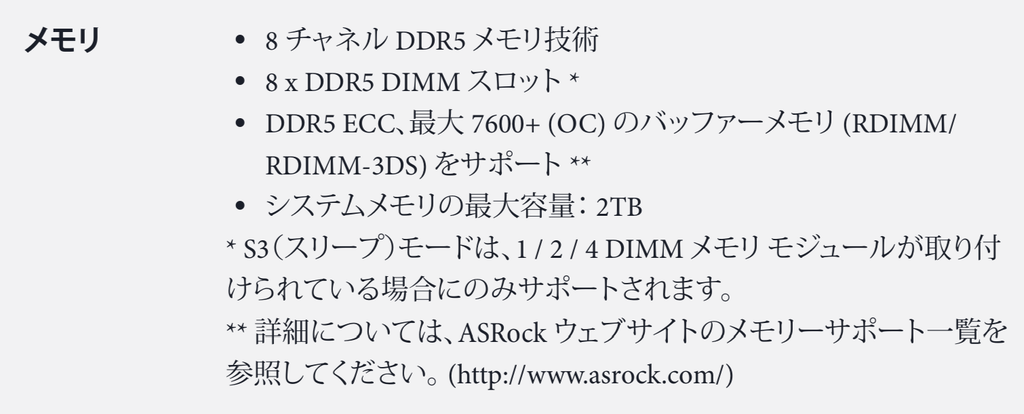
CPU定格の6400 MT/s(MHz)動作時でも約410GB/s(Gen1の2DPC比で約7.1倍)に達し、さらに仕様上の上限である最大7600+ MHz (OC)のモジュールを用いれば480GB/s超の世界が見えてきます。
さらに大容量RDIMM-3DS等を用いることで、最大2TBというエンタープライズサーバー同等の超広大空間を構築可能です。
数十GB〜数百GBに及ぶ巨大なLLMモデルをストレージから読み込み、メインメモリを経由してGPUへ送り込むデータ転送において、この8チャネルによる圧倒的なデータ転送速度(帯域)は、ロード待ち時間の短縮やVRAMあふれ時の処理速度に絶大な恩恵をもたらします。
GPU拡張性とPCIe 5.0レーン:同型GPU(Radeon AI PRO R9700 32GB)での比較
1.Gen1:物理的に1枚(32GB)が限界
構造上、CPU直結のPCIe 5.0 x16スロットが1基のみのため、GPUは1基しか搭載できません。
2.Gen2:4枚(計128GB)までフル帯域で直結
Threadripper PRO 9965WXから引き出されたPCIe 5.0の128レーンにより、2スロット厚の空冷GPUを4基搭載しても、すべてが「PCIe 5.0 x16(双方向約128GB/s)」の最高速で同時にリンクします。
「現在の実運用」とスモールスタート
理論上のモンスター構成を確認したところで、手元のリアルな運用環境に視点を戻します。
ここには、現況の市場動向(2026年9月現在)と、実際に運用してみる中で見えてきた「現在の最も合理的な着地点」という2つの理由が強く反映されています。
| 新旧の実運用スペック比較 | ||
| 構成要素 | Gen1(旧環境・Windows) | Gen2(現環境・Linux) |
| CPU | AMD Ryzen 9 9950X3D | AMD Threadripper PRO 9965WX |
| マザーボード | ASRock Rack B650D4U-2L2T/BCM | ASRock WRX90 WS EVO |
| GPU | GeForce RTX 5070 Ti (16GB) × 1 | AMD Radeon AI PRO R9700 (32GB) × 1 |
| 搭載メモリ | Kingston DDR5-5200 ECC UDIMM | A-Tech DDR5-4800 ECC RDIMM |
| (32GB × 2枚 = 計64GB) | (16GB × 3枚 = 計48GB) | |
| ストレージ | NVMe SSD(5TBとして運用) | 4TB NVMe SSD(メイン:Arch Linux) |
| + 1TB NVMe SSD(サブ:Windows) | ||
本音と市場の現実:なぜ最初からフル装備にしなかったのか?
身も蓋もない本音を言えば、「もし予算が無限にあるなら、最初から2TBメモリとGPU 4枚をフル装填して終わり」にしています。しかし現実の個人運用において、コストパフォーマンスを無視した投資はあり得ません。
現在、ハードウェアを取り巻く環境は極めて過酷です。
GPUは1枚あたり安くても25万円、最近では27万〜30万円近くまで跳ね上がっています。さらにサーバー向けのDDR5 ECC Registered DIMM(RDIMM)の相場も激しく高騰しています。
GPUを4基並べ、8チャネルメモリを最低限の構成(JEDEC定格の4800MHz 16GB×8枚)で揃えるだけでも、優に190万円以上の追加出費が吹き飛びます。
もしマザーボードの限界である2TB(4800MHz 256GB×8枚)をフル装填しようものなら、メモリ単体(V-Color等のエンタープライズキット)だけで51,199ドル(約800万円超)に達し、GPUと合わせて920万円以上という、高級車が1台買えるレベルの世界に突入してしまいます。
そこで今回は、eBayのオークションを駆使して手頃な価格で出品されていた「A-Tech DDR5-4800 1Rx8 ECC REG RDIMM 16GB × 3枚」を約9万7000円で落札し、まずは計48GBという変則的な3枚構成でスモールスタートを切ることにしました。
一般的な自作PCの常識からすると、メモリの「奇数枚(3枚)挿し」はデュアルチャネルの崩壊や相性問題を懸念して敬遠されがちです。しかし、各スロットが1チャネル1スロット(1DPC)として完全に独立配線されているWRX90とThreadripper PROのメモリコントローラーにとっては、単に「3チャネル分が独立して立ち上がった」に過ぎず、何のエラーもなくあっさりと認識し、トラブルフリーで堅牢な安定動作を提供してくれています。
クラウドの実力と、「それでもローカル環境を構える理由」
パーツ高騰の現実を前に、日々の作業を一度クラウドAI(Antigravityの定額環境)へ積極的にオフロードして検証を行いました。
実際に運用してみると、クラウドの最新モデルは驚くほど賢く、コストパフォーマンスも圧倒的です。自前で数十万円のGPUを維持する場合、ハードウェアの減価償却(GPU単体でも月額約8,000円〜)と常時稼働の電気代(月額数千円〜)を合わせるだけで、毎月約1.5万円〜規模の固定コストが発生します。これに対し、月額数千円のサブスクで最新モデルを叩けるクラウドは、経済合理性の観点から見れば遥かに安上がりです。
では、なぜわざわざThreadripperとLinuxサーバーを組んだのか?
それは、どれだけクラウドが進化しても「手元にローカル環境を構えていなければ絶対に越えられない壁」が存在するからです。
1.将来の機密資産・独自データを守る「絶対防衛ライン」
現在は個人の検証段階であっても、将来的に外部へ一切送信できない機密データ(未公開の回路設計・EDAデータ、契約書や財務情報、出願前の特許アイデアなど)を扱う場面が訪れることもあります。そうした用途が発生した際、手元に強力な計算基盤がなければデータを取り扱うこと自体が不可能になります。「いざという時に隔離環境で最高精度の推論を回せる器」をあらかじめ確保しておくことには、大きな保険としての価値があります。
2.クラウド特有の「過剰なガードレール(誤検知)」の回避
クラウドAIには厳格なセーフティフィルターが組み込まれています。しかし将来的に、セキュリティ関連の検証コードやドライバ・OS深部のエラーログを解析させる場面が出てきた際、悪意のない純粋な技術的デバッグであるにもかかわらず、フィルターの誤検知(False Positive)によってモデルに回答を拒絶されるリスクがつきまといます。今後の研究・開発においてAIに一切の忖度なくストレートな事実を出力させるためにも、検閲機構に縛られないローカル環境を手元に持っておく意義は小さくありません。
3.「ゲートキーパー(ルーター)」としてのローカル27Bモデル運用
現在構築しているローカル環境(VRAM 32GB)では、拒絶機構を無力化した「qwen3.8-abliterated:27b-q6_K」が快適に動作しています。27Bクラスの知能を持つモデルをq6_Kの高精度量子化で常駐させても、32GBのVRAM内にコンテキスト領域を含めて綺麗に収まります。
私はこのモデルを単なる作業用ツールとしてではなく、「外部と内部を仲介するゲートキーパー(ルーター)」として運用しています。
日常のインターフェースとして手元のモバイル等からタスクを投げる際、Telegram経由で送った指示をまず自宅サーバー上のQwenが受け取り、「これは機密性が低く、クラウドの知能に頼るべきか」「それとも外部に出さず、ローカル環境内で処理を完結させるべきか」を自動で振り分けます(ルーティングします)。
クラウドに出せる日常的な設計相談や高度な論理構築はフロンティアモデルへパスし、プライベートな判定やローカル完結タスクは自前のローカル環境で引き受けます。これが、現時点における私の最も合理的で実践的な回答です。
開発の主軸を「Linuxネイティブ」へ移した理由
Gen1ではリモート操作の扱いやすさや汎用性を考慮してWindows環境をメインに据えていましたが、今回のGen2では日常の開発やサーバー運用の主軸をLinux(Arch Linux)ネイティブへ移行しました。
もちろんWindowsを完全に手放したわけではありません(後述の通り物理ドライブを分けたデュアルブート構成として残しています)。しかし、ハードウェア設計(EDA)とローカルAI運用を突き詰めるにあたり、普段の作業基盤をWindowsからLinuxへ切り替えることには2つの決定的な必然性がありました。
1. 半導体・EDAツールのデファクトスタンダード
FPGA開発や回路設計で用いられるEDAツール(Intel Quartus Prime等)は、元来UNIX/Linux環境を前提に設計・最適化されてきた歴史があります。
Windows版も提供されてはいますが、大規模な論理合成や配置配線、シミュレーションを実行する際、プロセスの生成、ファイルI/O、メモリのページ管理においてLinuxネイティブ環境の方が圧倒的なスループットを発揮します。ハードウェア本来の性能を引き出すには、開発の足回りそのものをLinuxネイティブに置くことが最も理にかなっていました。
2. 「AIエージェントによる自律保守」との親和性
日常の開発ワークフローにおいて、AIエージェントにシステム構築や環境セットアップを委譲する運用スタイルを重視しています。
この時、Windows特有のGUI前提の操作系、不透明なレジストリ、独自のパス構造はエージェントにとって大きな障害となります。一方、Linuxは「すべてがプレーンなテキストファイル、パイプライン、そして明確なCLIコマンドで構成される世界」です。
不具合が発生した際も、エージェントがシステムログを直接読み解き、自律的にコマンドを発行して環境を修復・再構築できる扱いやすさは、Windowsでは得られない大きなアドバンテージです。
物理SSD分離によるデュアルブート:Windowsを残した理由
開発の主軸をLinuxへ移したとはいえ、本機ではWindows環境を完全に消去するのではなく、4TBと1TBの2枚のNVMe SSDを物理的に分けた「完全分離型デュアルブート」を採用しています。
- 4TB NVMe SSD: メイン環境(Arch Linux / Podman / AI・EDA作業領域)
- 1TB NVMe SSD: サブ環境(Windows 11 / クリエイティブ・互換性用)
1台のSSDの中でパーティションを切り分けるデュアルブートは、Windows Updateなどの拍子にブートローダー(EFI領域)が上書きされ、Linuxが起動しなくなるトラブルが起きがちです。しかし、物理ドライブごと独立させておけば、互いのブート領域やファイルシステムを巻き込む心配が一切ありません。
DaVinci Resolveとクリエイティブ環境への保険
Windowsを残している最大の理由は、DaVinci Resolveによる動画編集などのクリエイティブワーク環境を担保するためです。
現在はサーバー環境やLinux側のパイプライン整備を優先しているため、Windows側を日常的に頻繁に立ち上げているわけではありません。しかし、将来的に高解像度の動画編集や、Windows環境でしか動かない検証ツールを動かす必要が生じた際、Threadripper PROとRadeon AI PROの火力をそのままWindows上で解放できる環境を手元に残してあることは、実用上の大きな安心感に繋がっています。
Arch ✕ Podman (AlmaLinux) の階層構造を採用した理由
Linuxをメインに据えるにあたり、ホストOSには「Arch Linux」を、そして実際の開発・EDA環境には「Podman上のAlmaLinux」を組み合わせた2層アーキテクチャを採用しました。
ホストに「Arch Linux」を選んだ理由
最新のハードウェアアーキテクチャ(Zen 5世代のThreadripper PROや最新GPU)の性能を極限まで引き出すには、常に最新のカーネルとドライバ(amdgpu)が供給されるローリングリリースモデルが理想的です。
また、世界最大のコミュニティリポジトリであるAUR(Arch User Repository)の存在も大きな決め手でした。今後開発を進める中でニッチなツールや特殊なライブラリが必要になった際も、圧倒的なパッケージ網を誇るArchなら手詰まりにならずに済むだろうという「将来への安心感・保険」としての期待を込めて採用しています。デスクトップ環境には高機能で堅牢なKDE Plasmaを組み合わせ、日常的な作業の快適性も確保しています。
EDAの実行基盤に「Podman (AlmaLinux)」を挟む理由
EDAツールは非常に保守的であり、RHEL(Red Hat Enterprise Linux)系ディストリビューションを公式サポート基準としています。ホストのArch Linux上に直接展開しようとすると、古いglibcや共有ライブラリのバージョン不整合に直面します。
そこで、RHEL完全互換である「AlmaLinux」のコンテナを立ち上げ、その閉じた空間内でEDAツールを動かす構成を取りました。
DockerではなくPodmanを採用した理由は、デーモンレスかつルートレスで動作し、ホストOSを汚染することなくセキュアにGPUやディレクトリをパススルーできるためです。現在、このコンテナ内でQuartusを問題なく稼働させています。
日本の100V環境とマルチGPU:CLIによる「電力制御」の必要性
将来的な最大構成として「GPU 4基搭載」を見据えるにあたり、避けて通れないのが「日本の家庭用電源(100V 15A=1500W)の壁」です。
なぜ単一「2500W電源(SilverStone HELA 2500Rz)」を採用したのか?
本サーバーには、SilverStone製の単一電源ユニット「HELA 2500Rz(2500W)」を採用しています。1500W制限のある日本のコンセント環境において、あえてこの超大容量電源を選定した理由は以下の3点です。
- 瞬時電力スパイク(過渡負荷)への耐性
CPUと4基のGPUが一斉に高負荷に入った瞬間、ミリ秒単位で定格を超える突入電流(電力スパイク)が発生します。1500Wジャストの電源では保護回路(OCP)がトリップしてシステムが落ちるリスクがありますが、2500Wの受け皿があれば受け流すことができます。 - 変換効率のスイートスポット運用(Cybenetics Platinum)
電源ユニットは定格の40%〜60%(本機では1000W〜1500W付近)で動かす際が最も高効率で発熱が少なく、ファンの回転数を低く抑えた静音運用が可能です。 - 将来の200V 給電への布石
将来的に給電環境を整えた際、電源ユニット自体を買い直すことなく即座にフルパワーを解放できる設計的余裕を持たせています。
ROCm CLIによるスマートな「パワーリミット(Power Capping)」
壁のコンセント(1500W)を超えさせないための現実的なアプローチは、ハードウェアの構成を諦めることではなく、「ソフトウェア(CLI)で上限を厳密に統制すること」です。
Linux環境下では、AMDのGPU管理ツールであるrocm-smiを用いることで、スクリプトから確実に消費電力の上限を設定できます。
例えば、Radeon AI PRO R9700の最大消費電力(TDP)を1枚あたり220W前後に制限する場合、以下のコマンドを実行します。
sudo rocm-smi --setpoweroverdrive 220※ --setpoweroverdrive 220 でGPU 1枚あたりの最大消費電力(TDP)を220Wに固定し、マルチGPU時でも家庭用コンセント(1500W)の枠内に安全に収めます。
今後の展望:人間とAIのインターフェース構築に向けて
ハードウェアの刷新とLinuxへの移行により、強固な計算基盤は整いました。現在取り組んでいるのは、この強力なサーバーと日々のワークフローをシームレスに結ぶ「人間とAIの協調インターフェース」の構築です。
すでに本サーバー上では以下の仕組みが稼働しており、日々のタスク管理と開発を支えています。
- Telegramを通じたリモートタスク指示
外出先や手元の端末からTelegramを介してサーバーへ自然言語でタスクを投入。 - Obsidian(情報基盤 & カンバンボード)との連動
ObsidianのMarkdownファイル群をAIが直接参照。カンバンボードにタスクが追加されたことを検知してバックグラウンドで処理を開始し、終了後にステータスを自動更新。(カンバンボードへ直接タスクを書き込む形でも指示可能) - ローカルQwen 3.8(27B)とクラウドモデルのハイブリッド協調
タスクの機密性や要求スペックをローカルのQwenが初動で判断し、クラウドとローカルを使い分けるルーティング運用。
こうした基盤の上で、直近では以下のような検証・実証を進めていく予定です。
今後公開予定の検証・実証記事
このシステム構成と、今回構築した「Arch Linux × Podman × Quartus Prime」環境がどこまで実用に耐えうるのか、以下の2本の個別記事で詳しく解説・実証していく予定です。
- 【システム編】Telegram × Obsidian × ローカルAI:自作サーバー上で動く自律型エージェントのアーキテクチャ
日常のインターフェース(Telegram/Obsidian)とAIエージェントがどのように連携し、タスクを処理しているのか、そのソフトウェアアーキテクチャを解説します。 - 【実践デモ編】Telegramから「MAX 10 FPGAのHDL設計・コンパイル・カメラによる実機LED動作検証」までをAIで自律実行
本システムの実践例として、MAX 10評価ボードとカメラをサーバーに接続。「LEDが指定通りに光るようHDLを書き、Quartusでコンパイル・エラー修正を行い、カメラで実機の点灯パターンを撮影して設計通りか確認せよ」というタスクをTelegramから入力した際、エージェントがどこまで自律的に完結できるかを検証します。※本環境(Arch Linux上のPodman+AlmaLinux内でQuartus Primeを動かす構成)の完全な動作実証デモも兼ねています。
手元にある1枚のGPUと48GBのメモリから始まった「Gen2」ですが、その足元には無限の拡張性と可能性が広がっています。この強力な相棒とともに、ハードウェア設計と自律型AIが融合する未来をさらに探求していきます。